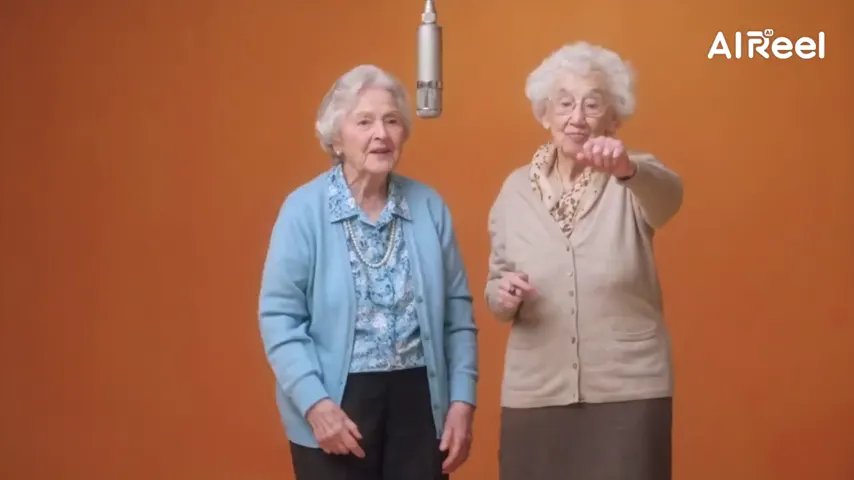
不用摄制组
场景由预设提供。你只要给一张静态人像,再选好设置。
让一张人像动起来
先想好你想看到哪一刻:镜头一路拉到太空,身边站满一排复制人,或者在扮装场景里换个新造型。上传一张光线好的人像照,选一个预设。照片负责“是谁”,特效负责“发生什么”。
想做自己的 AI 视频,就上传一张清楚的正面照,选一个单人特效,工作室会在浏览器里生成一个可以下载的 MP4。用 Seedance 2.0 Mini,720p、5 秒 4 积分,按视频服务商的估计约 5 分钟以内出片。这是付费功能,积分包 10 积分 $9.99 起。再加一张照片,就能用为两个人设计的场景。另外的说唱模式总是两位表演者。
最近修订
从照片到场景
一个特效就是一份预先写好的分镜:它规定了场景、镜头运动和声音方向,而人像照片告诉模型要画的是谁。你不用写提示词,也不用拼剪辑时间线。选一个预设,看一眼实时的积分总数,然后生成。
大多数场景会要求模型保住看得见的脸、头发和衣服。有几个是专门用来改造型的:“万圣节扮装”会换衣服,“光头滤镜”会去掉头发,“80 年代家庭录像”会加上那个年代的质感。即便如此,成片里的脸和原照片之间还是可能有细微差别。
简单设置
用一张明亮、清晰的照片,脸没有遮挡、朝着镜头。把不该出现在场景里的人裁掉。
这个页面默认打开“拉远到地球”。在特效列表里换一个场景,再看看生成按钮旁边更新后的总价。
按视频服务商的估计,出片时间约 5 分钟以内。做好后下载,或者之后回到“我的视频”里找。
点生成之前
场景由预设提供。你只要给一张静态人像,再选好设置。
模型把照片里的人当作参考。生成的画面里,小细节可能会有变化。
工作室默认 9:16,适合短视频信息流。Seedance 可选的比例有16:9、9:16、1:1、4:3、3:4 或 21:9。
720p、5 秒是 4 积分。换时长或清晰度,数字可能会变。
双人场景要给每个人一张照片,或者一张两个人都在的合照。两个人在画面里怎么相遇,由特效的设定决定。
如果你想要的是一段音乐表演,就打开 Hotel Lobby 视频制作器。它把两个人放进橙色布景,一个人说唱,一个人在旁边帮腔,用 Wan 3.0 做 12 秒是 6 积分。想要一段定制的歌词,AI 说唱生成器会按你给的主题来写,720p、12 秒 10 积分。这种说唱流程必须是两个人。
用你自己的照片,或者在制作和分享之前,得到朋友或家人的明确同意。不要上传陌生人、明星或其他公众人物的照片。
我们自己的成片
两段样片,下方列出模型、时长和来源。它们用于展示流程,不代表生成成功率。
Wan 3.0 · 480p · 10 秒 · 16:9
Wan 3.0 · 720p · 12 秒 · 16:9
网上的作品
这些视频用来展示这种形式。它们由其他人用其他工具制作,每条都注明作者并链接到原帖,不是 Hotel Lobby Video 的成片。
单人预设只要一张清楚的人像。这里默认选好了“拉远到地球”;不是你想要的效果就换一个场景,然后看价格、生成 MP4。
不能。720p、5 秒的特效是 4 积分,这里没有免费生成。积分包 10 积分 $9.99 起。
能。用较新的手机浏览器打开网站,从相册里选一张照片,做好后下载 MP4。
不会。上传的照片会引导画面里的人,但 AI 生成的画面可能会改变脸部、衣服或背景的小细节。一张清楚的正面照能给模型更好的参考。
不能。说唱模式是为两位表演者做的。想要带音乐的单人场景,“Raindance”用一张人像就能拍日落码头。
选一个为两个人设计的特效,每人放一张照片,或者放一张合照。说唱视频也是一个双人选项。
预设从 5 秒开始。你可以换成其他支持的时长,积分总数会跟着变。按视频服务商的估计,出片时间约 5 分钟以内。
只有得到本人同意才可以。不要用陌生人、明星或其他公众人物的照片。