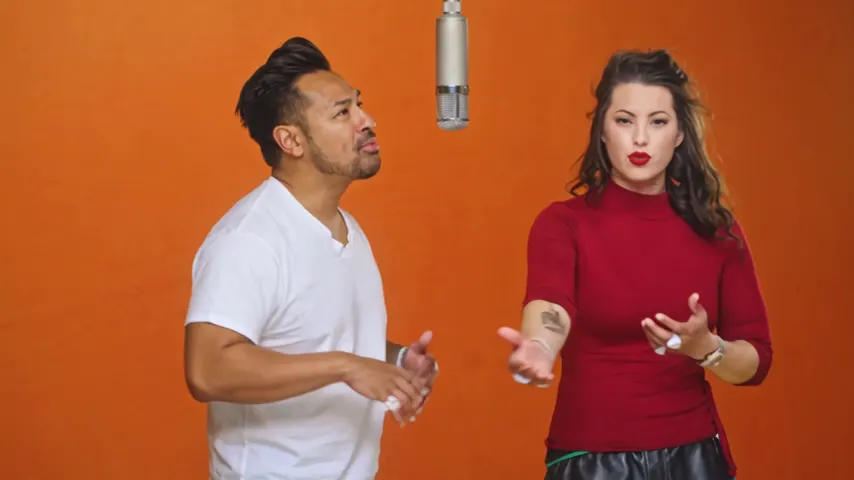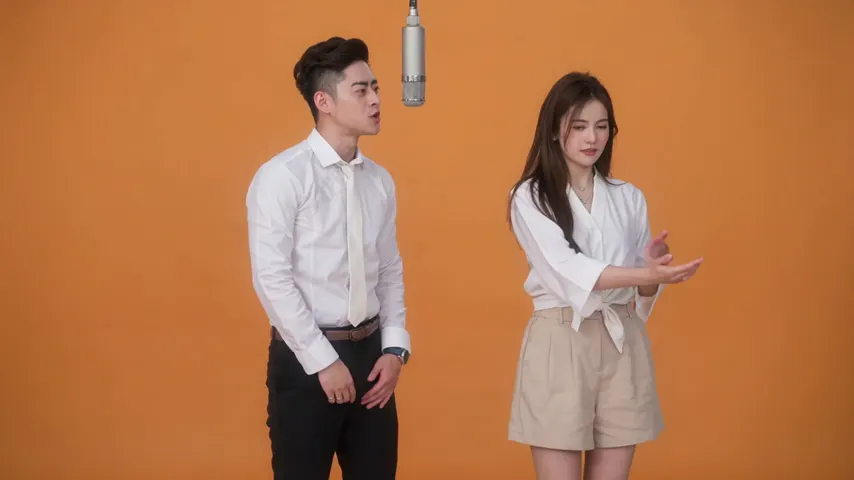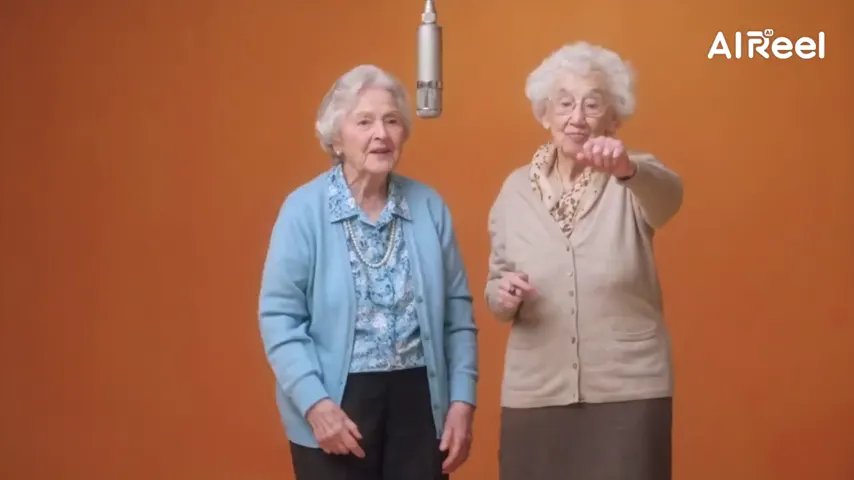
主唱加搭档
一个人扛这段词,另一个人喊彩、跳舞。这就是潮流捧红的那种分工。
说唱歌手就是你
这里的 AI 说唱歌手视频,主角是你,不是一个编出来的虚拟角色:放进你和朋友的人像,给这段词一个话题,你们俩就围着一支麦唱一段新写的说唱。12 秒 10 积分,你一点 flow 都不需要。
哪里不一样
在搜索框里输入“AI 说唱歌手”,冒出来的大多是虚构的角色、虚构的名字。看着挺乐,但那不是你。这间工作室反过来从你的相册出发:一张你的人像,一张朋友的,剩下那些你工作日晚上做不来的事,从写词、人声到表演本身,都交给 AI。
把它当成给两个人订了一场录音。开着“两人都唱”,你们分掉这段词,轮流接句。关掉它,左边的人像就是主唱,右边的当搭档,指指点点、哈哈大笑、踩着拍子晃。
走到麦前
左边的人像开口起头;右边的接话,如果“两人都唱”关着,就只负责垫词。把照片对调,角色就对调。
最多 120 字,或者干脆不写,就唱你们俩自己。想一起分词,就开着“两人都唱”。
默认先载入潮流里的橙墙布景;另外三个布景把这对搭档换个地方唱,价格一样。
玩法
一个人扛这段词,另一个人喊彩、跳舞。这就是潮流捧红的那种分工。
两个声音把一支麦递来递去。特别适合兄弟姐妹、情侣,和所有爱斗嘴的人。
用德语、他加禄语或西班牙语写话题,词就用那种语言回来。框里留空,就用页面语言。
上传一段 2 到 15 秒的舞蹈片段,两人一边说唱一边照着它的动作和运镜来。
一条成片只用一个人设,话题里写上真名。想不出梗?翻翻搞笑说唱歌词点子。
| 工具类型 | 画面里是谁 | 你最后拿到什么 |
|---|---|---|
| 虚拟歌手 App | 一个编出来的人设 | 这个人设的歌曲和图片 |
| 写词工具 | 没有人,只有文字 | 一页歌词 |
| Hotel Lobby Video | 你加一个朋友,来自人像 | 一个你们俩唱新词的 MP4 |
我们自己的成片
两段样片,下方列出模型、时长和来源。它们用于展示流程,不代表生成成功率。
Wan 3.0 · 480p · 10 秒 · 16:9
Wan 3.0 · 720p · 12 秒 · 16:9
网上的作品
这些视频用来展示这种形式。它们由其他人用其他工具制作,每条都注明作者并链接到原帖,不是 Hotel Lobby Video 的成片。
能,这正是重点。放一张你清楚的人像和一张朋友的,或者一张两人同框的,工作室就让你们动起来唱一段新词。
说唱做不了。每条说唱成片都有两位表演者。单张人像可以走“效果”标签,但效果只有环境声,没有唱词。
不是。人声随歌一起生成,不模仿任何人。想听到你真实的声音,就自己录一段,用“你的音轨”上传,主唱会对着它对嘴型。
能。每张人像各用各的,不同城市、不同手机、不同年份拍的照片,最后照样并排站在麦前。
用 Seedance 2.0 Mini、720p,12 秒 10 积分,任何布景都一样,包括橙墙。没做成的会自己退款。
不能。照片里只能是同意出镜的人。明星、公众人物和陌生人都不行。